こんにちは。
最近ローカルLLM界隈が盛り上がっています!
ChatGPTやClaudeのようなクローズドモデルに匹敵する性能をたたき出すものも出てきました!
特にQwen3.8やOrnith1.5あたりは衝撃的なベンチマークスコアでした!
こうした高性能なモデルをローカルで動かすために、DGX Sparkのような高性能なマシンへの注目も高まっていますね。
一方で、私は「高性能な巨大モデルを動かすこと」よりも、「一般的な環境でも扱える小型モデルをどこまで実用的にできるか」に興味があります。
というわけで前回はテキストモデルでしたが、今回は画像を扱えるマルチモーダルモデル(以下VLM)の学習方法について紹介したいと思います。

今回も無料のGoogle Colabで動かせるノートブックを用意したので、お試しレベルでの動作確認もできます。
VLMのチューニング方法についてご興味のある方はご参考ください。
それではよろしくお願いします。
VLMに画像の品質評価(IQA)をさせてみる
ローカルLLMの盛り上がりに加えて、最近面白い論文を見つけたのも本記事を執筆する動機だったりします。

ByteDance社が開発した画像品質評価(IQA)用のLLMフレームワークです。
IQAという分野はDeepLearningの頃からモデルもいくつか存在します。
私もDeepLearningモデルで使ってみたことがあるのですが、出力結果があまり感覚に一致しなくて実運用には難しかった記憶があります。
人間の主観に近いIQAモデルを作るためには、膨大な学習データとアノテーション(正解ラベル・グラウンドトゥルース)が必要になります。
課題としては手作業でやると大変な上に、アノテーションの品質にばらつきがでてしまいます。
そもそも人間の主観を扱うIQAでは、唯一の絶対的な正解を定義するのが難しいため、多数の人にアノテーションを行ってもらい、平均値などを用いるのが一般的ですが、とてもコストも時間もかかります。
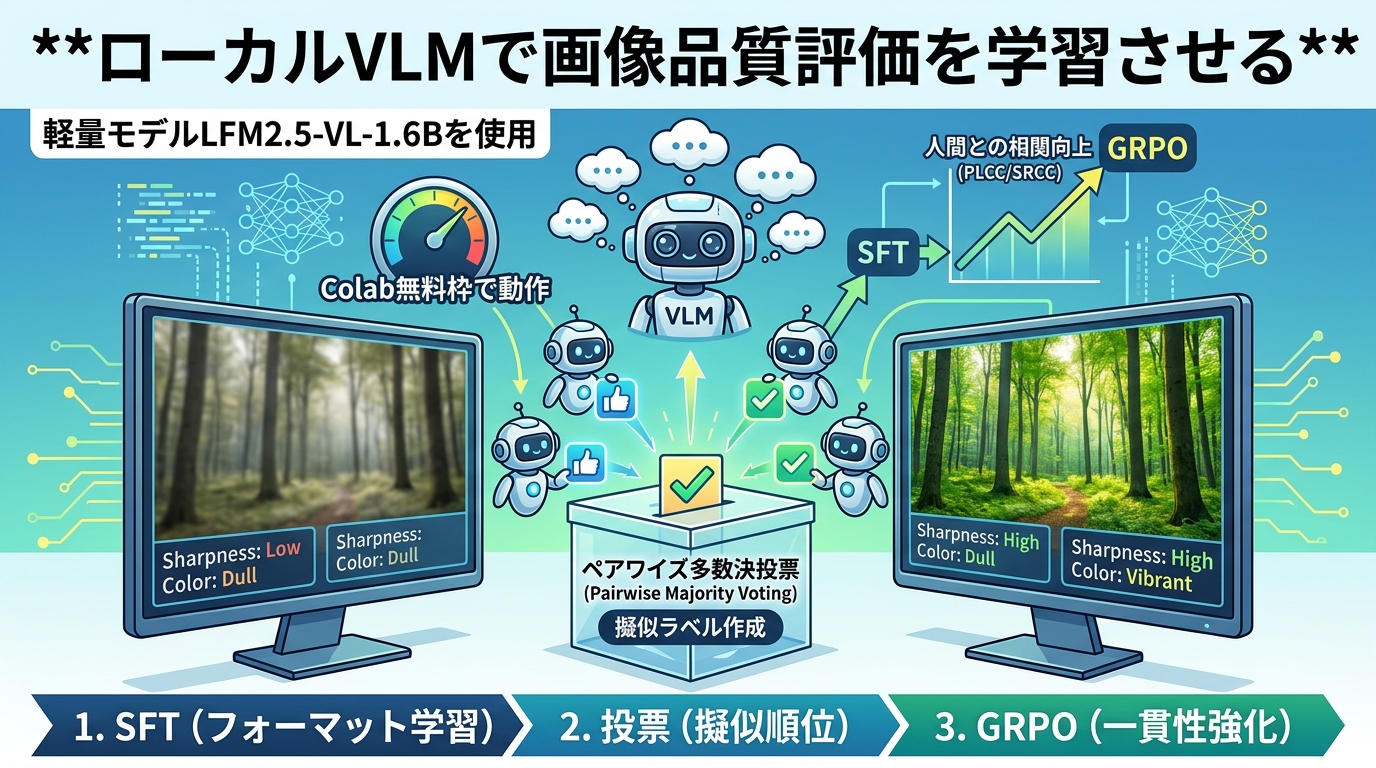
EvoQualityはペアワイズ多数決投票(Pairwise Majority Voting)という手法でこの課題の解決を目指したようです。
2枚の画像からペアを作り、同じペアに対してモデルに複数回回答を生成させます。
その結果を多数決することで、「どちらの画像の品質が高いか」という擬似的な順位ラベルを作成します。
これは、LLMのプロンプトエンジニアリングでよく使われる「自己整合性(Self-Consistency)」という手法を、IQAに応用した考え方です。

通常、LLMに質問すると、1回の生成結果だけをそのまま回答として採用します。
しかし、複雑な問題では1回の推論だけでは偶然誤った結論にたどり着くことがあります。
自己整合性では、同じ問題に対して複数の推論経路を生成させ、それぞれの回答を集計します。
複数の異なる推論を経ても同じ結論にたどり着く回答ほど、信頼性が高いと考えるわけです。
最終的には、多数決などを利用して最も一貫性のある回答を採用します。
EvoQualityは、まさにこの自己整合性の考え方をIQAに適応したものです。
複数回の評価で一貫して「画像Aの方が高品質」と判断されるなら、その結果をより信頼できる擬似ラベルとして採用するという仕組みです。
あとはその正解をより回答するようにGRPOで強化していく自己進化型の手法です。
ここで登場する報酬関数Fidelity Rewardsがとても重要なのですが、それについての解説は内容が難しく長くなるため、気になる方は後々紹介するNotebookをご覧いただくか、論文をご覧いただくのが良いかと思います。
さて少し長くなりましたがEvoQualityの概要としては以上です。
個人的な感想としてはとても合理的な手法で勝算もありそうな気がします。
一方で懸念点としては、使うモデル次第なところもあり、モデルがもともと獲得している学習データによるバイアスなどの影響は少なからずあるように思います。
ただこれも強化学習で使うデータセットや報酬関数の工夫をすればある程度対策はできるのではないかと思います。
このGithubではベースモデルはQwen2.5-VL-7B-Instructですが、Google Colabの無料枠で動かすのはリソース的に難しそうです。
前回も使用したLFMシリーズのVLMである、LFM2.5-VL-1.6Bを使って、同じようなことができないか検証してみました。
モデル:LFM2.5-VL-1.6B
おそらく私が知るVLMの中では最も最軽量、かつ高精度なモデルです。
圧縮なしの16bitでもVRAM使用量は約3GB、GGUFの4bit量子化版であれば約700MBと、1GB以内で動作させることもできます。
これはGPUリソースがなくてもCPUでの推論も可能なサイズ感です。
最近3Bもリリースされたので、そのうち検証してみたいところです。
リソースの観点から、今回は1.6Bを使用しました。
データセットは、EvoQualityと同様にKonIQ-10kを使いました。
データセット:KonIQ-10k
IQAの分野ではよく使われるデータセットです。
1,459 人のクラウドワーカーから 120 万件の信頼できる品質評価を取得し、より汎用的な IQA モデルへの道を開きました。
という説明もある通り、人のブレや品質評価に対して、かなりの人手を割いて作られたデータセットです。
フルサイズと小さいサイズの2種類がありますが、今回はお試しのため小さいサイズの一部を使います。
パイプライン(処理の流れ)とNotebook
基本的に前回と概ね同じ流れです。
- SFT: KonIQ の MOS(人の総合評価の平均)と公式インジケータ(brightness / colorfulness / contrast / sharpness)で JSON を出力するよう LoRA 学習する
- オフライン投票(EvoQuality): 画像ペアをモデル自身に何度も比較させ、多数決で擬似順位ラベルを作る
- GRPO: 擬似順位を fidelity 報酬にして、相対品質の一貫性を強化する
- 評価: MOS との PLCC / SRCC(どれだけ人の評価に近いか)、サンプル推論
Google Colab Notebookは以下になります。

前回同様、「ファイル」→「ドライブにコピーを保存」して使ってください。
RUN_MODE = “demo”と“full”の2パターン設定ができますが、今回はdemoで紹介します。
パラメータを制限し、データセットも一部で使用するため、大体30~40分程度で完了できるお試しモードです。
興味とリソースに余裕のある方はfullにしてみたり、データセットをフルサイズのものやパラメータを変更したりして色々試してみてください。
結果
学習がうまくいっているかどうか、SFTのparse_rateとGRPOのPLCC/SRCCを見ていきます。
parse_rateは、モデルが出力した結果を指定したJSON形式として正常に解析できた割合です。
そのため、parse_rateが1.00に近いほど、指定したフォーマットに従って安定して出力できていると判断できます。
PLCCとSRCCは-1から1の範囲を取る相関係数です。
1に近いほど人の評価と強い正の相関があり、0に近いほど関係が弱く、-1に近いほど人の評価と逆の傾向を示します。
ベースモデルのLFM2.5-VL-1.6BからSFTやGRPOでどのぐらい変化があった、出力結果は以下です。
=== Base vs SFT vs GRPO ===
metric Base_PLCC Base_SRCC Base_parse SFT_PLCC SFT_SRCC SFT_parse GRPO_PLCC GRPO_SRCC GRPO_parse
brightness 0.665 0.825 0.312 0.233 0.219 1.0 0.118 0.016 1.0
colorfulness -0.223 -0.085 0.312 0.198 0.200 1.0 0.303 0.273 1.0
contrast 0.369 0.332 0.312 -0.211 -0.179 1.0 -0.130 -0.107 1.0
sharpness 0.446 0.406 0.312 0.455 0.457 1.0 0.311 0.363 1.0
overall 0.176 0.172 0.312 0.435 0.496 1.0 0.345 0.494 1.0
要点に合わせて表を作成します。
まずはSFTです。
フォーマット学習がうまくいっているかどうかをみたいため、parse_rateのみ表にします。
| 評価段階 | parse rate |
|---|---|
| Base | 0.312 |
| SFT | 1.000 |
parse_rate=1.00となっており、学習はうまくいっていることがわかります。
次にGRPOです。
こちらは各スコアがうまくいっているかどうかみたいため、PLCC/SRCCで表にします。
| metric | Base PLCC | Base SRCC | GRPO PLCC | GRPO SRCC |
|---|---|---|---|---|
| brightness | 0.665 | 0.825 | 0.118 | 0.016 |
| colorfulness | -0.223 | -0.085 | 0.303 | 0.273 |
| contrast | 0.369 | 0.332 | -0.130 | -0.107 |
| sharpness | 0.446 | 0.406 | 0.311 | 0.363 |
| overall | 0.176 | 0.172 | 0.345 | 0.494 |
colorfulnessとoverallにおいて、改善が見られます。
一方でbrightnessとcontrastでは悪化していることがわかります。
このことから、今回のGRPOによってモデルの出力は変化しているものの、すべての品質指標を一貫して改善できるほど十分な学習には至っていない可能性があります。
そのため、GRPOの効果を十分に引き出すには、より多くの画像ペアや学習ステップを用意し、各種パラメータを調整する必要がありそうです。
では実際に学習したモデルでテストしてみましょう。
13. 好きな画像を採点する のところでGRPOした結果をテストできます。
キャンセルボタンを押せば、KonIQ-10Kのテストデータを使って評価結果が出ます。
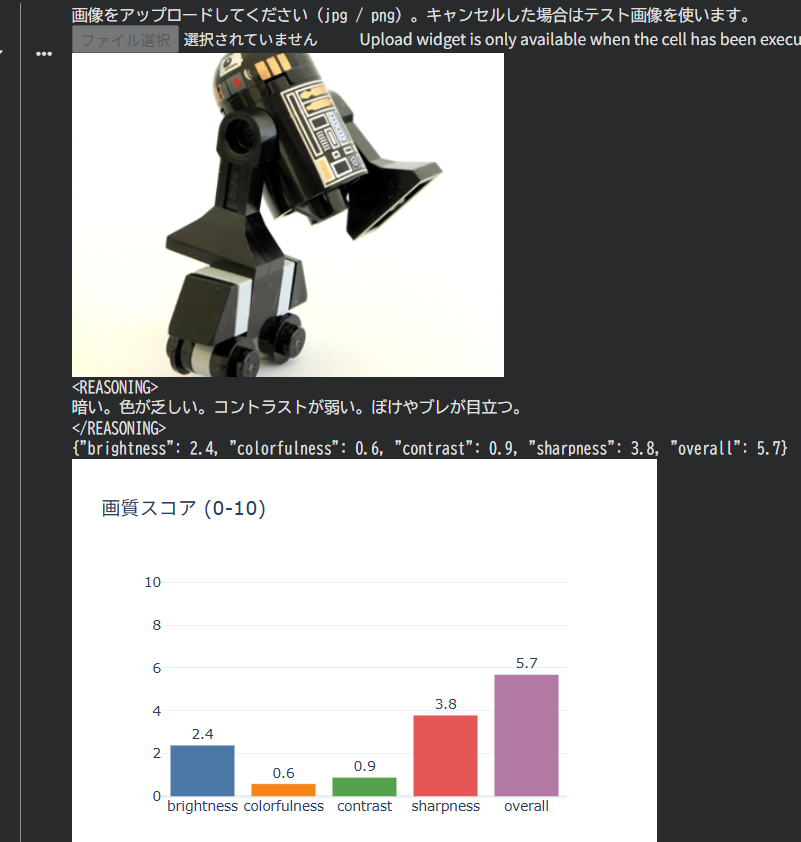
REASONINGの説明文を見ると、方向性としては正しいように見えます。
モデルの能力を狙った方向に変化させられる兆しは確認できたかと思います。
まとめ
今回は軽量VLMであるLFM2.5-VL-1.6Bを使ってSFT→ペアワイズ投票→GRPOという流れをGoogle Colabで一通り実験してみました。
お試し用で30~40分程度で無料で動かせる実験でしたが、それなりに効果の兆しを確認できたかと思います。
実際のユースケースに合わせて、データやパラメータやリソースを用意すれば、実践的なVLMを作成できるのではないかと思います。
現場で使えるVLMの開発の参考になれば幸いです。
ここまでご覧いただきありがとうございました!
