こんにちは。
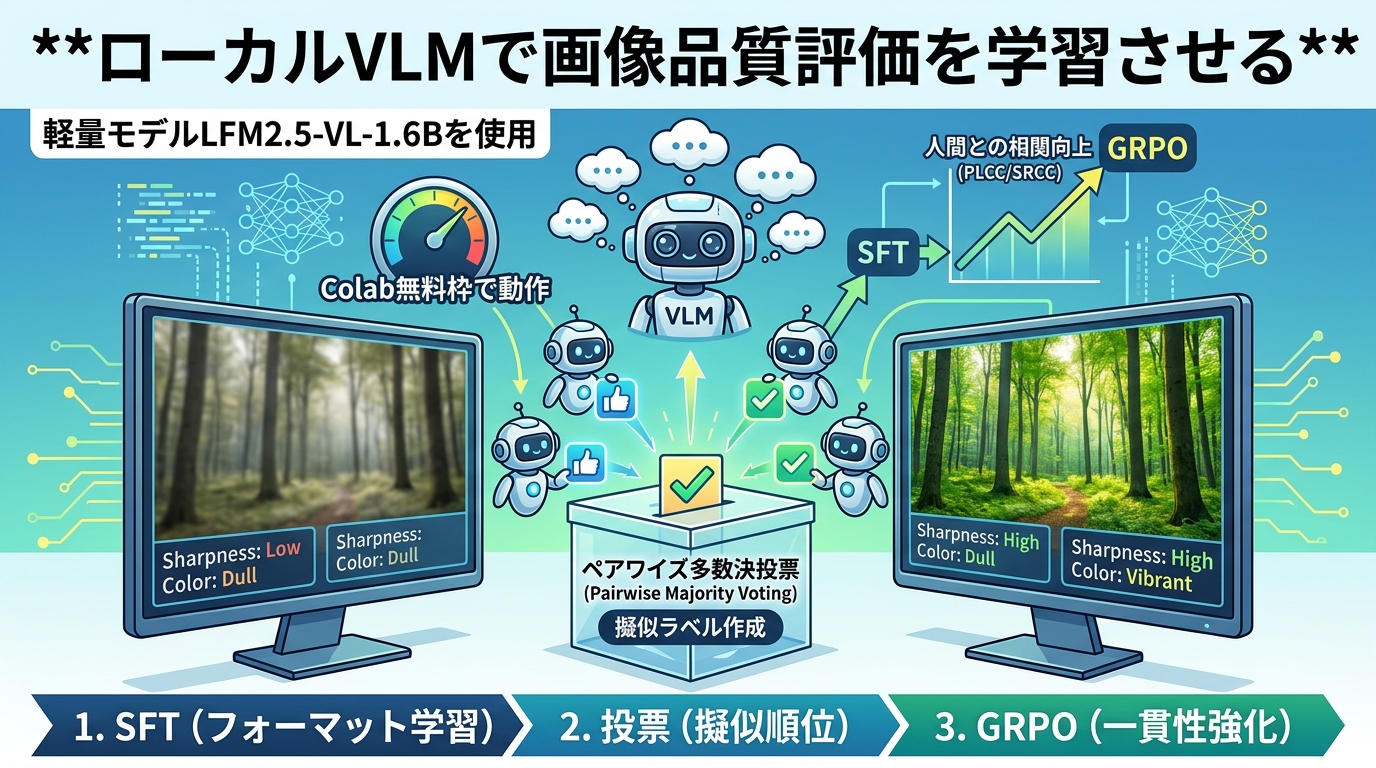
前回作成したVLMを更に改良して、スマホアプリ上で動くのかどうか試してみたいと思います。
前回の記事:
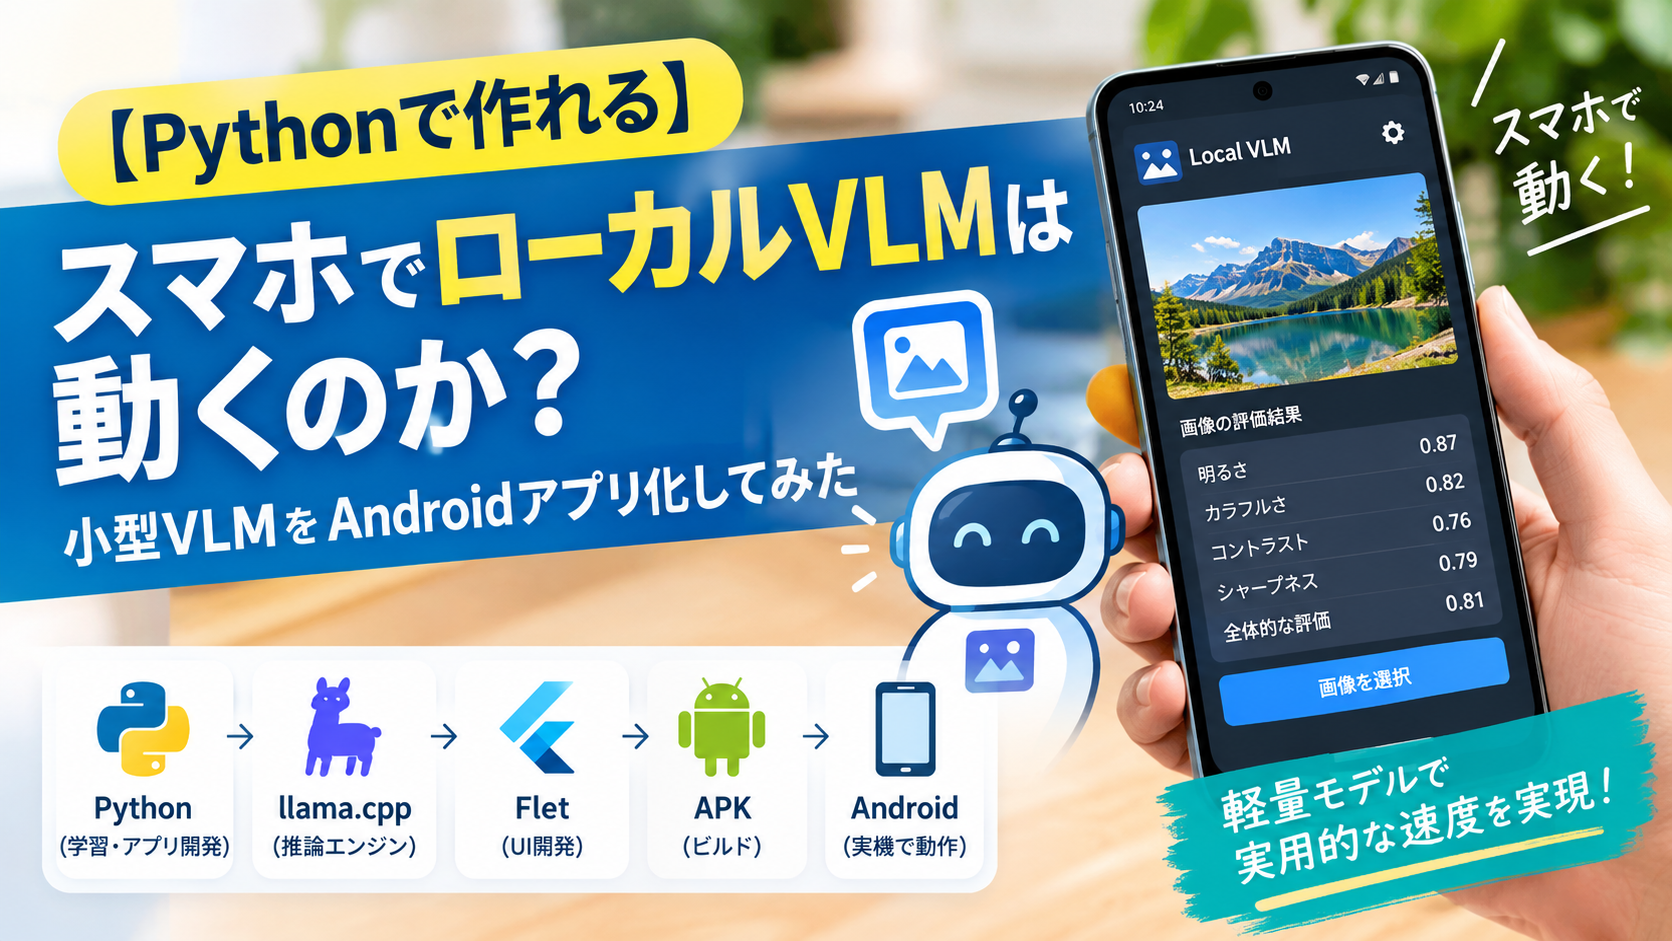
小型ローカルVLMはPC上ではさくさく動くことはわかっていますが、スマホ上で動かすことはできるのでしょうか?
PCのような高性能GPUはありませんし、CPUもPCに比べれば非力です。
果たして小型LLMなら動くのかどうか、それを今回は検証してみたいと思います。
また今回使用するモデルは前回と同様、自分で訓練したモデルを使います。
つまり、自分の使いたい目的に調整したAIをスマホに入れて持ち運べるのかどうか、という観点も重要です。
自分で作ったAIをスマホに入れて動かしてみたい方の参考になれば幸いです。
それではよろしくお願いします。
モデルをLFM2.5-VL-450Mに変更
前回の記事ではLFM2.5-VL-1.6Bを使いましたが、スマホ上での推論速度やモデルのダウンロードサイズも重要になるため、更に小型のLFM2.5-VL-450Mをベースにファインチューニングしてみました。
スマホなどのエッジデバイス向けに作られたモデルで、1GB未満という驚異的な軽さです。
今回のタスクも画像の品質評価ということで限定的ですし、小型モデルでもそれなりにできるのではないかと判断しました。
基本的な学習コードは前回のものとほぼ同じなので割愛しますが、Full設定よりも多めに設定したり、いくつかパラメータを変更しました。
性能としては以下のような感じです。
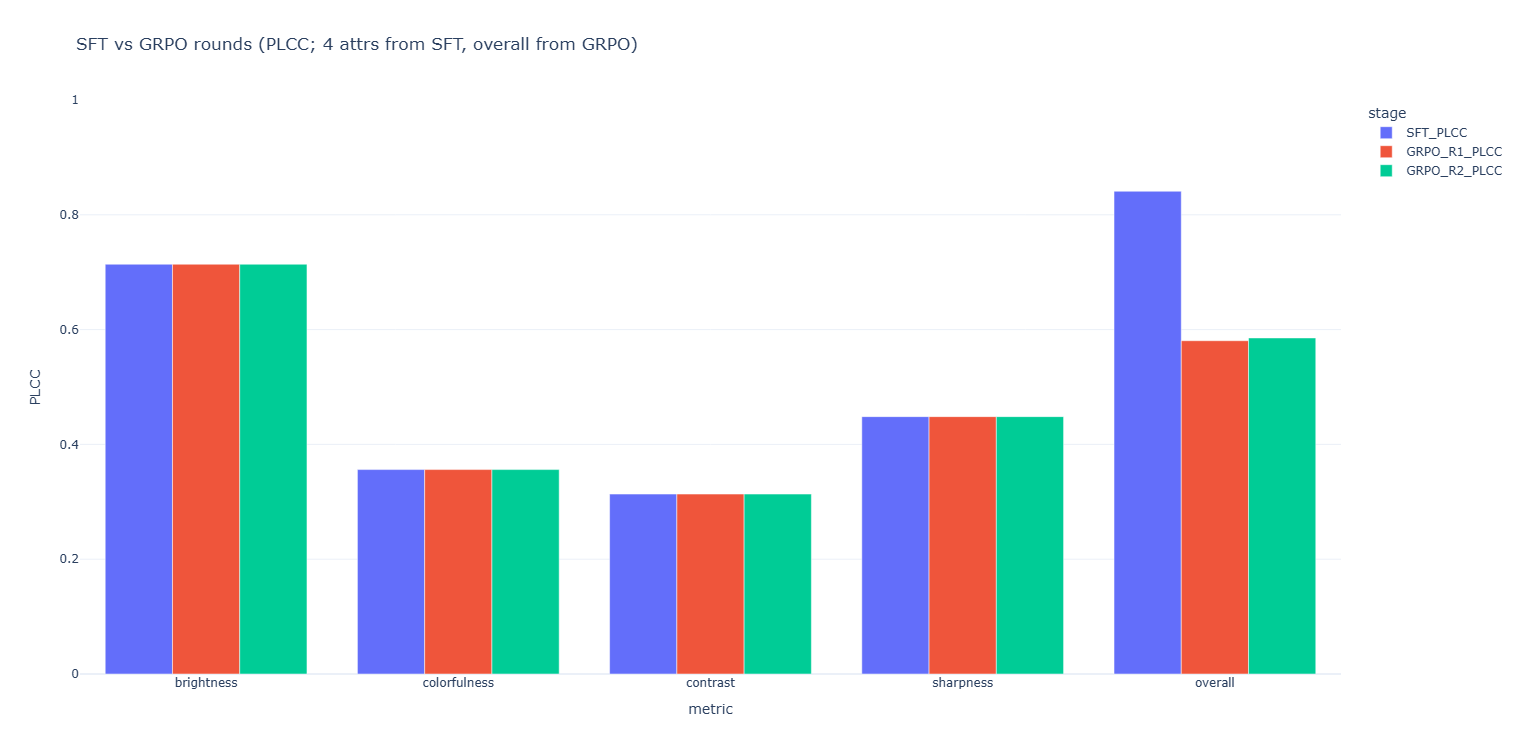
縦軸がPLCCで、これが1に近いほどモデルの予測値とKonIQ-10Kの正解ラベルが強く相関していることを示します。
各棒グラフは明るさ、カラフルさ、コントラスト、シャープネス(輪郭がはっきりしてボヤけてないか)、全体的な見た目の印象、の順になっています。
前回はDemo版ということもあり、学習が不十分なスコアでした。
今回はFullバージョンでしっかりリソースを使ってパラメータも設定しましたので、小さいモデルでも性能が出ています。
overallがGRPO(強化学習)の対象になりますが、KonIQ-10KではSFTの方が高い結果となっています。
今回はスマホでの実用性を重視するため、overallでPLCC 0.84を記録したSFTモデルを採用します。
本来は汎用性の観点からGRPOの方を採用したいのですが、SFTよりもスコアが想定以上に低かったので断念しました。
推論エンジン:llama.cpp
LLMを高速で推論するための推論エンジンにllama.cppを使いました。
量子化したGGUF形式のモデルを、C/C++で高速に推論できるようになります。
スマホアプリで少しでも軽く高速に推論するために導入しました。
量子化により精度の劣化は多少ありますが、今回は動かすことが目的なので問題ありません。
Flet
今回はPythonでもスマホアプリを作れるライブラリとして、Fletを選定しました。

Flutterを基盤とした、Web・スマホアプリをPythonだけで作れるクロスプラットフォームなライブラリです。
デザインに時間をかけず、サクッとモダンなデザインに仕上げたい人におすすめです。
クロスプラットフォームなライブラリとしてはkivyも伝統的に人気ですが、今回は手軽さの観点からFletにしました。
Python/FletでUIを作り、llama.cppでローカル推論する、というイメージです。
開発・実行環境
開発PC:Windows
スマホ:moto g64 5G(RAM:8GB、ストレージ128GB)
スマホアプリ作成工程の全体像
これらを使ってスマホアプリを作成するまでの工程の全体像を示します。
① [学習済み LoRA]          [ベース HF: LiquidAI/LFM2.5-VL-450M]
        │                              │
        └──────── merge (PEFT) ────────┘
                       │
                       ▼
              マージ済み HF(一時)
                       │
         ┌─────────────┴─────────────┐
         ▼                           ▼
 convert_hf_to_gguf            convert_hf_to_gguf --mmproj
         │                           │
         ▼                           ▼
 LFM2.5-VL-450M-sft-Q8_0.gguf   mmproj-LFM2.5-VL-450M-F16.gguf
         │                           │
         └─────────────┬─────────────┘
                       ▼
②            Hugging Face Hub にアップロード
                       │
                       ▼
③            flet.cli build apk
                       │
                       ▼
④ 実機にインストール → 初回起動時に Hub から DL(APK 外)→ 採点
全体像を説明すると
- 学習済みLoRAとベースモデルでGGUFを作成する
- GGUFをHugging Face Hubに置く
- FletでAPKファイルをビルドする
- AndroidスマホにAPKをインストール → 初回起動時にモデルをDL → 推論
量子化についてですが、VLM はもともと言語と視覚がモジュールとして分かれたアーキテクチャとなっています。
今回は言語側だけQ8の量子化を実施しました。
視覚側を量子化しない理由は、精度劣化の懸念です。
量子化がVLMの性能にどのような影響があるかを調査した論文もご参考ください。

LFM2.5-VL-450Mの視覚部分はSigLipというアーキテクチャです。
SigLipは比較的量子化による精度劣化の耐性はあるという主張もありますが、一方で速度が改善しないなどの報告もあります。

視覚部分は言語部分に比べればサイズは小さいため、得られるメリットよりもリスクが高いと判断し、今回は量子化を見送りました。
また小型モデルとはいえ、APKファイルには含められないため、モデルはHuggingFaceに登録しておき、アプリ起動時にスマホにダウンロードする仕組みにしました。
Fletのビルド周りについては、基本的には以下の公式に従い、flet build apkコマンドでいけます。

公式にもありますが、Visual Studio周りのビルド環境を整えたり、Android SDKなど追加する必要があります。
また今回のケースで少し引っかかったこととして、画像付き推論に必要なmtmd(旧 llava)はそのままビルドすると認識されないことがわかりました。
本来ならllama.cppに標準で入っているのですが、Androidは別途libmtmd.soを追加してあげる必要があるようです。
このあたりは環境依存の部分も多く、wheelやpyproject.tomlを調整して対応しました。
ビルドが完了したらbuildフォルダ内のAPKファイルのみをGoogleドライブなどにアップします。
あとはAndroidスマホでGoogleドライブからAPKファイルを開けば、インストールが開始します。
実機画面
では実際に実機で動くのか、APKファイルからインストールしてみました。
アプリを起動すると・・
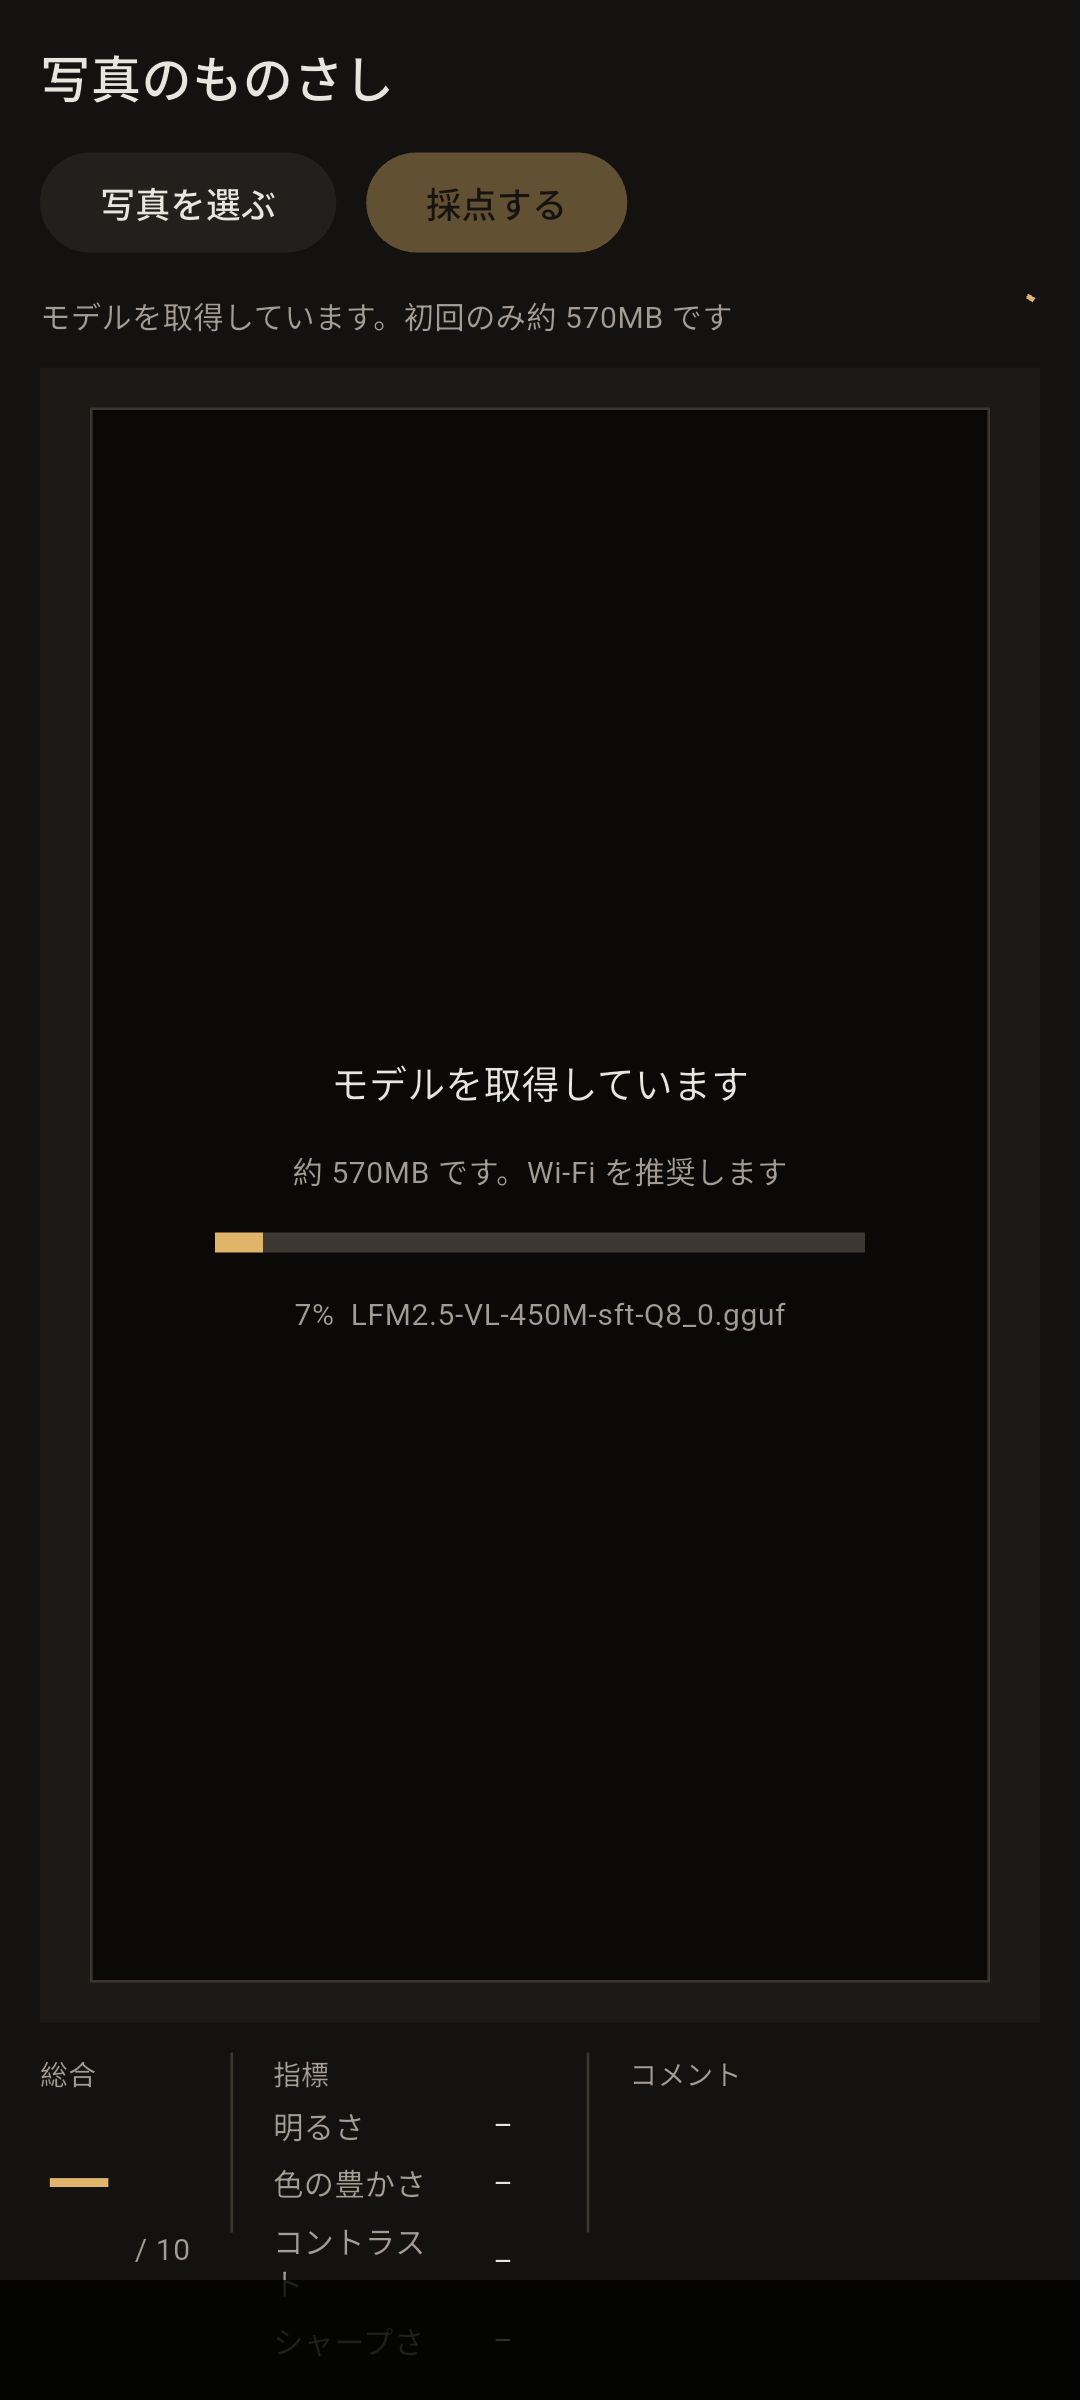
自動的にHuggingFaceからモデルをダウンロードできています!
約570MBですが、通信環境にもよりますが2~3分でダウンロードが完了します。
ダウンロードが終わったら「写真を選ぶ」で何か適当に画像を入れて「採点する」ボタンを押して採点します。
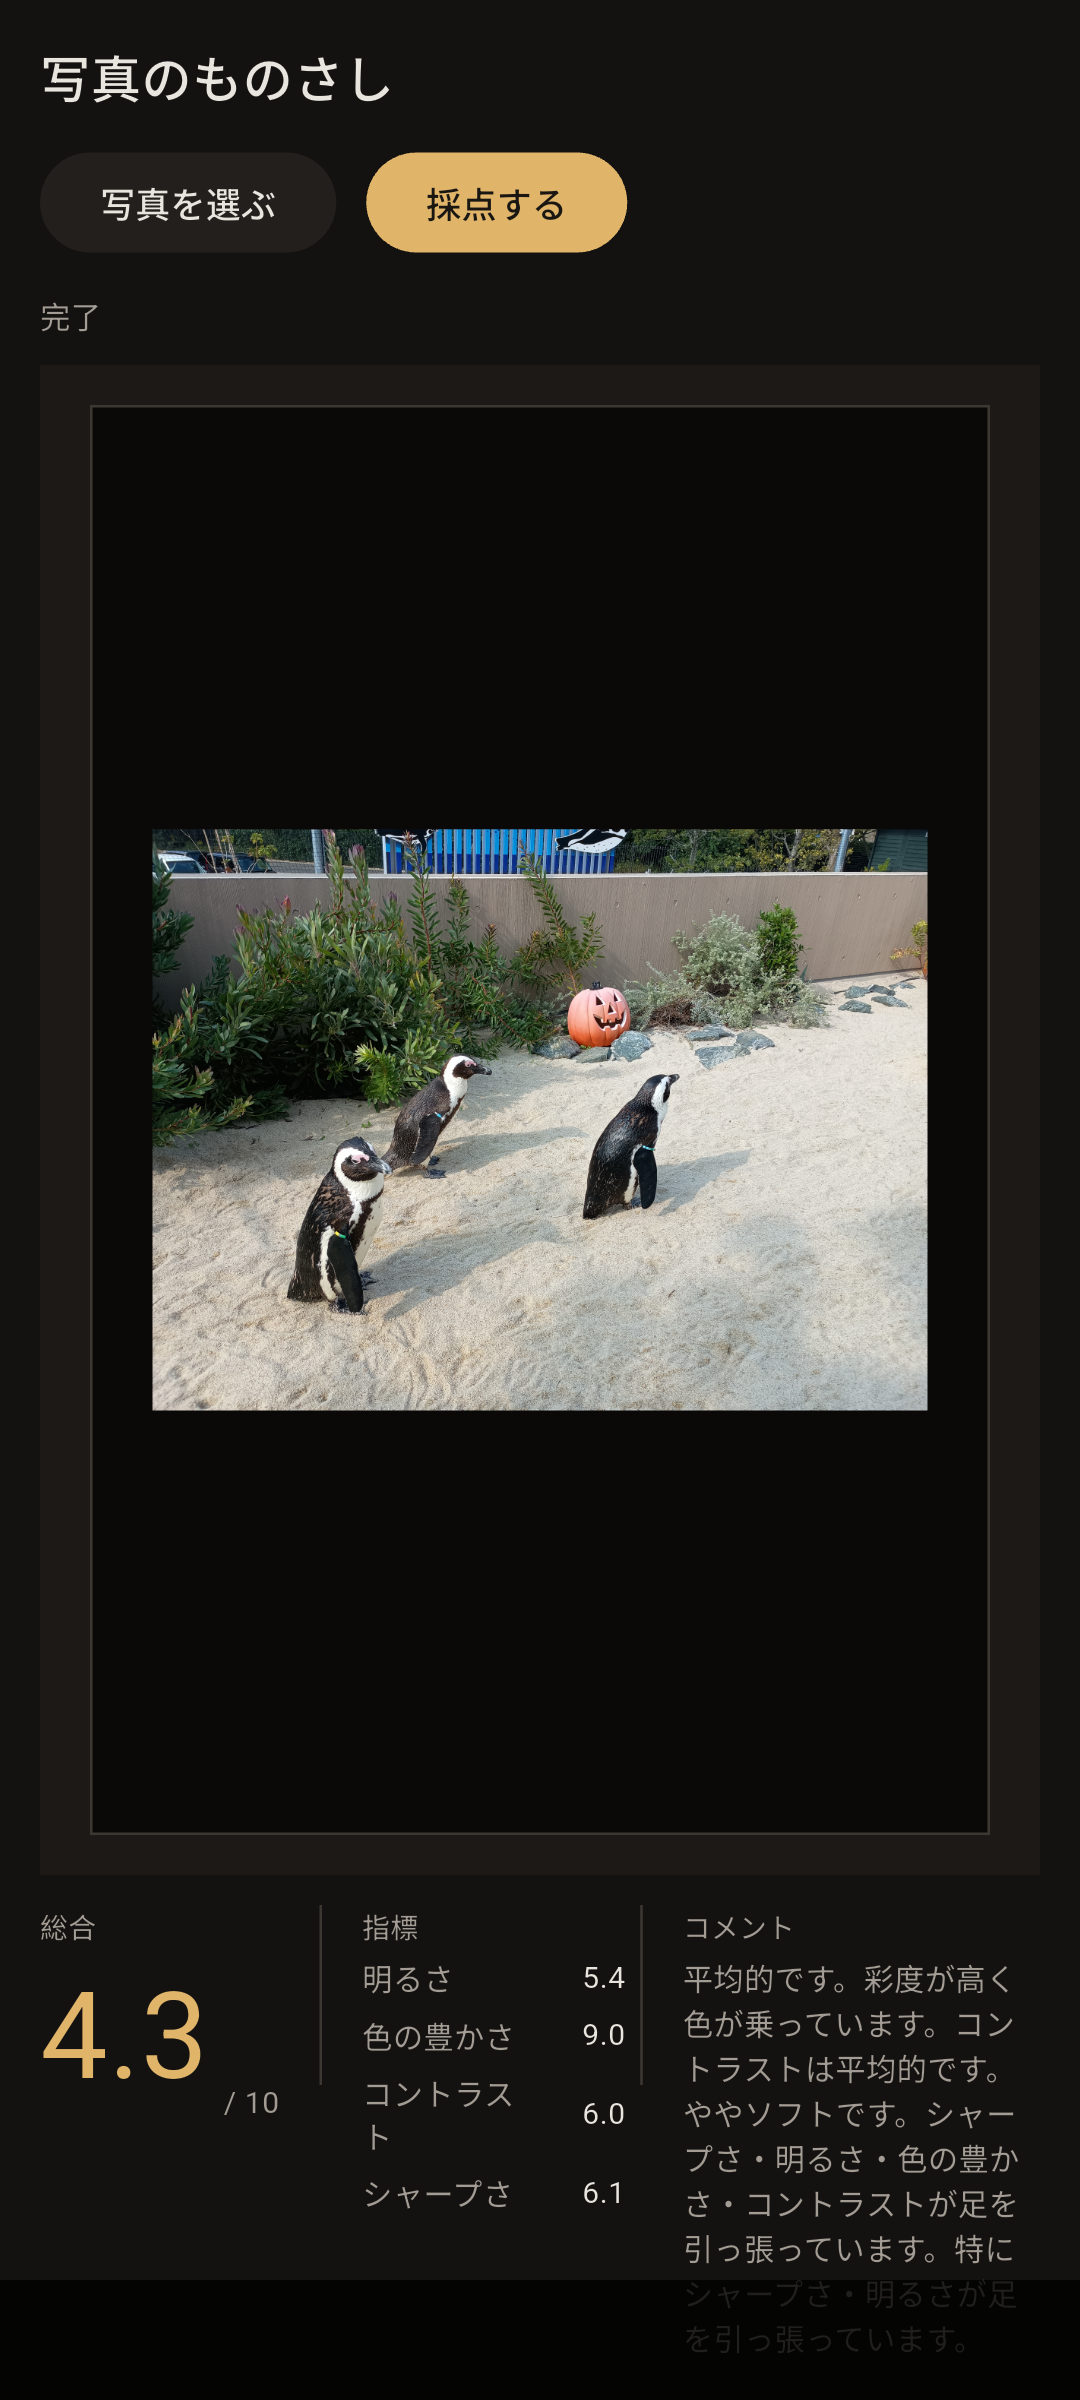
問題なく動きました!
推論時間も大体20~30秒程度で、そこまで遅い感じではありません!
もう一枚他の写真を。
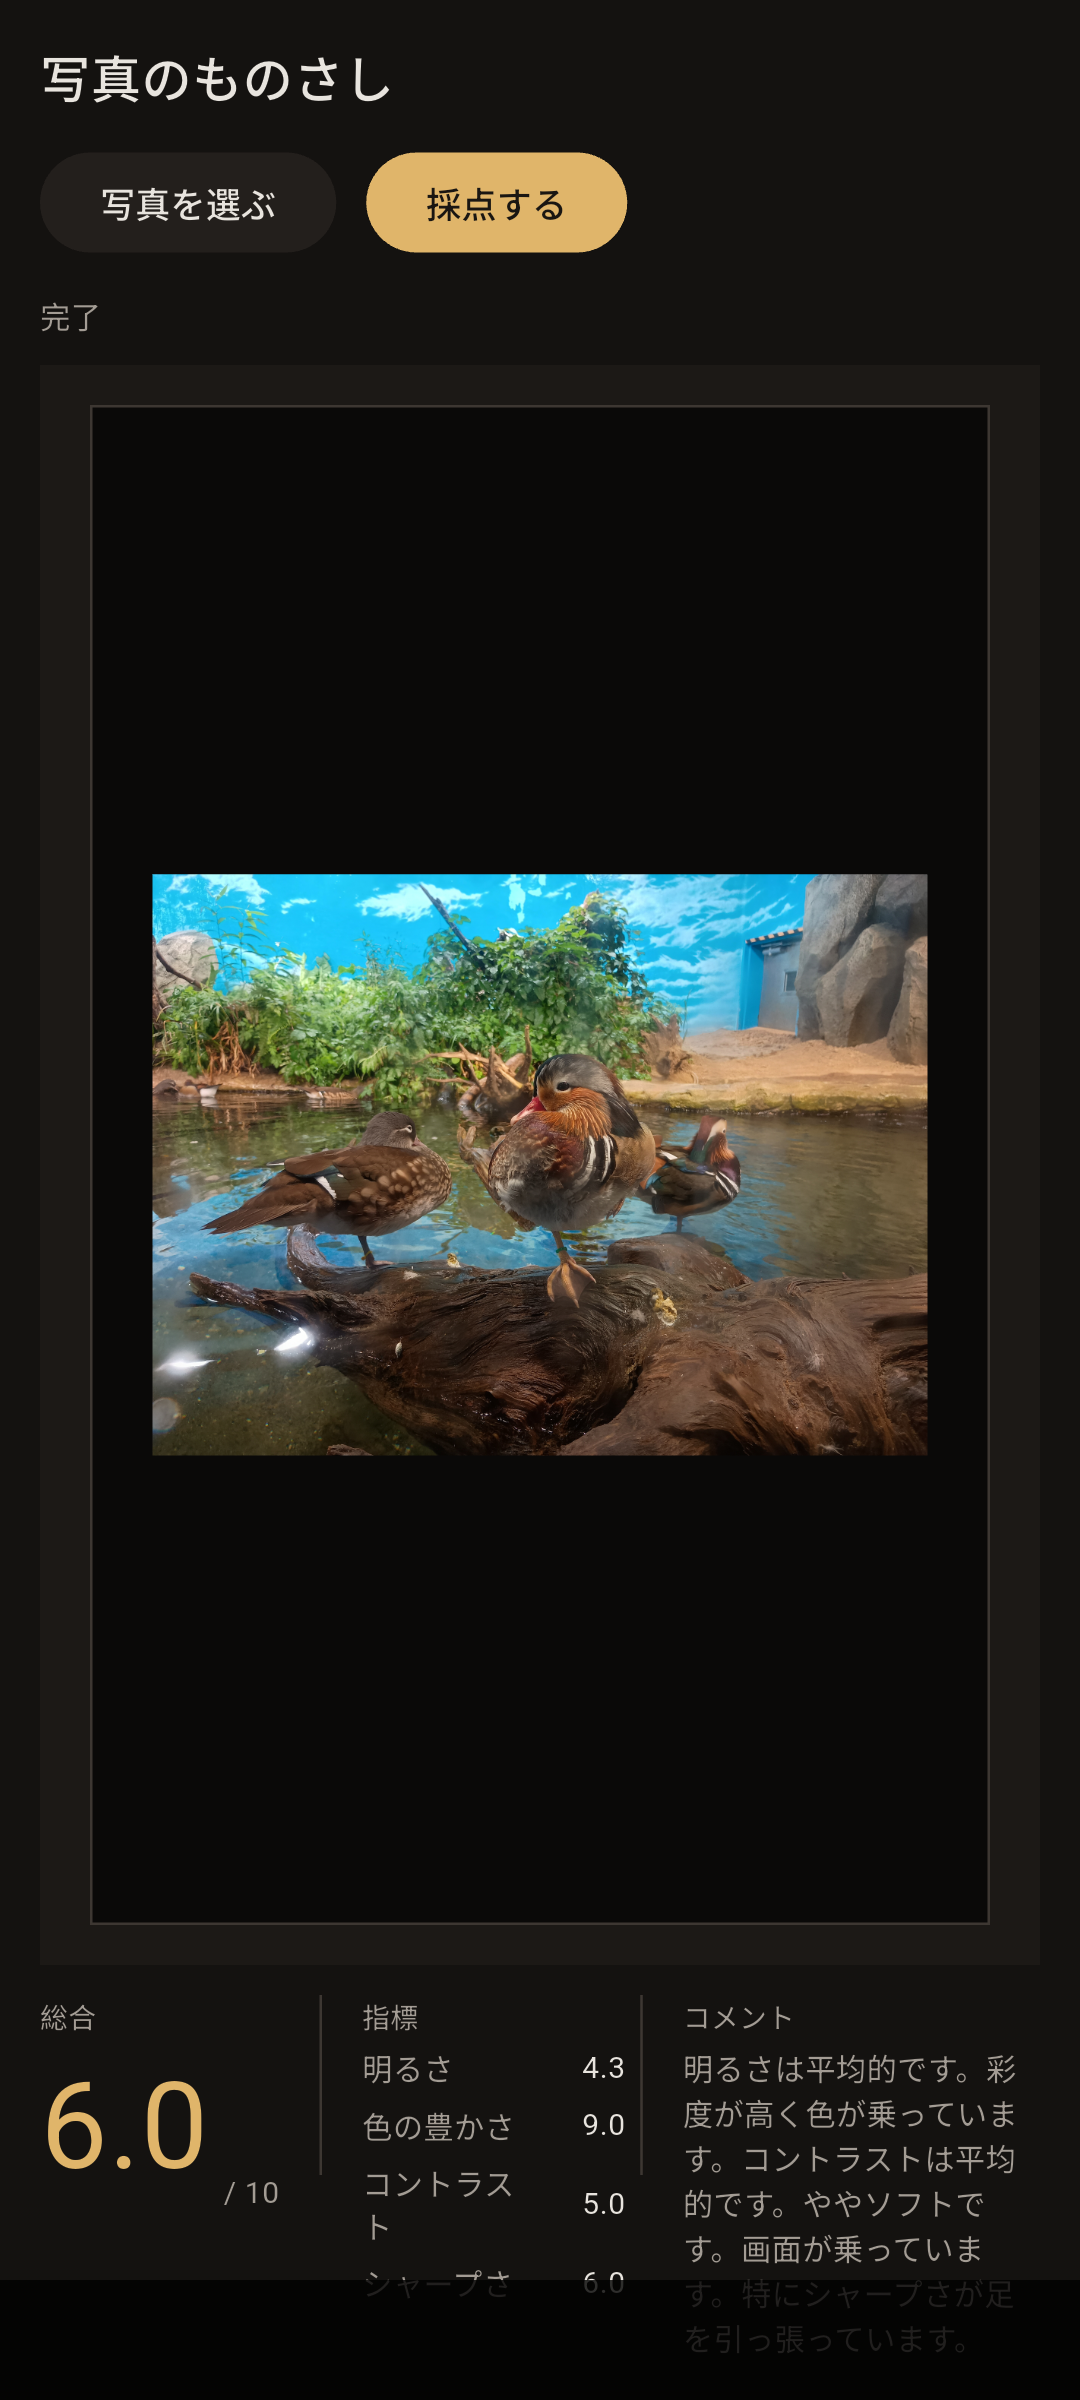
結論:RAM 8GBのmoto g64 5Gでは、450Mモデルで実用可能な速度で動作できます。
アプリのサイズは大体90MBぐらいで、ダウンロードしたモデルも同じストレージに保存されますので、合計で700MBぐらいです。
アプリをアンインストールすると、モデルも一緒に削除されます。
推論自体はスマホ内で完結するためクラウド型の画像AIとは異なり、写真を推論のために外部サーバーへ送信する必要がありません。
HuggingFaceからモデルをダウンロードする時はWifiなどオンライン環境が必要ですが、ダウンロードしてしまえばインターネットがないオフライン環境でも動かせるのは強みです。
山の中などでの撮影などに良いかもしれませんね。
今回の評価結果を最後にまとめておきます。
| 項目 | 内容 |
|---|---|
| スマホ | moto g64 5G |
| RAM | 8GB |
| ストレージ | 128GB |
| モデル | LFM2.5-VL-450M |
| モデル容量 | 約570MB |
| 推論時間 | 約20~30秒 |
| アプリ(APKファイル) | 約90MB |
| 合計使用容量 | 約700MB |
まとめ
今回はスマホでローカルVLMが動くのかどうかを検証しました。
結論としては、小型LLMなら高性能スマホでなくても問題なく動かせることがわかりました。
余談ですが、1.6Bのモデルでも検証してみましたが、問題なく動かせます。
ただし、モデルサイズが1.2GB(言語側をQ4まで落としても)あるため、ダウンロード時間がやや長く、推論時間も1分30秒ぐらいかかるので、ちょっと時間がかかりすぎですね。。
精度を優先するなら1.6B、速度やダウンロードサイズなど実用性を優先するなら450Mとなるかと思います。
そしてもう一つわかったこととして、「自分で作ったAIをスマホに入れて持ち運べる」ということです。
スマホで動かせるAI開発、とてもワクワクしますね!
これを機にスマホ開発についても勉強してみようかと思います!
ここまでご覧いただきありがとうございました!